自己対局データをさらに2倍に増やしたが、強さの伸びは頭打ちになった
前回の実験では、学習行数を約42万行に固定したまま、教師データの母集団となるゲーム数を7,350局から29,400局へ拡大することで、局面評価(value)の汎化性能と実対局での勝率がともに向上することを確認した。
そこで今回は、同様のアプローチでゲーム数をさらに2倍(58,800局)へと拡大した場合、モデルの実力にさらなる伸びしろが存在するかを検証した。
結論から述べると、局面評価のオフライン予測誤差にはわずかな改善が見られたものの、実対局の勝率を向上させるまでには至らなかった。
実験の設計と条件設定
Splendor では、同一の初期盤面について先手・後手を入れ替えた2局を1組(group)として評価する。
本実験では、以下の2条件を比較した。
| 項目 | G14条件(対照群) | G29条件(実験群) |
|---|---|---|
| 訓練用グループ数 | 14,700組 | 29,400組 |
| 参照ゲーム総数 | 29,400局 | 58,800局 |
| 学習に使用する総行数 | 419,840行 | 419,840行 |
| 1ゲームあたりの平均サンプリング行数 | 14.28行 | 7.14行 |
| オプティマイザ更新ステップ | 8,000 | 8,000 |
ゲーム数のみを倍増させ、ネットワーク構造、教師AI、損失関数、オプティマイザ、学習行数、更新ステップ数といった条件はすべて完全に同一に揃えた。
G29はG14の2倍の対局を参照するが、学習行数は同数であるため、1ゲームあたりから抽出する局面数は半減する。すなわち「同一の約42万行という学習予算の中で、少数の対局から密にサンプリングするか、多数の対局から薄く広くサンプリングするか」という比較実験となる。
乱数シードに起因するブレを抑えるため、12組の独立した実験ペア(計24モデル)を学習させた。各ペアにおいてG14とG29は同一の初期重みとデータ提示順序シードを共有している。
モデルの選定には、検証データセットに対する結合損失(joint loss)が最小となったチェックポイントを機械的に選択した。テストデータや実対局の結果を確認した後にチェックポイントを選び直す操作は一切行っていない。
学習曲線とチェックポイントの選定傾向
学習データに対する損失の推移を確認することで、24モデルの学習が正常に収束しているかをモニタリングした。
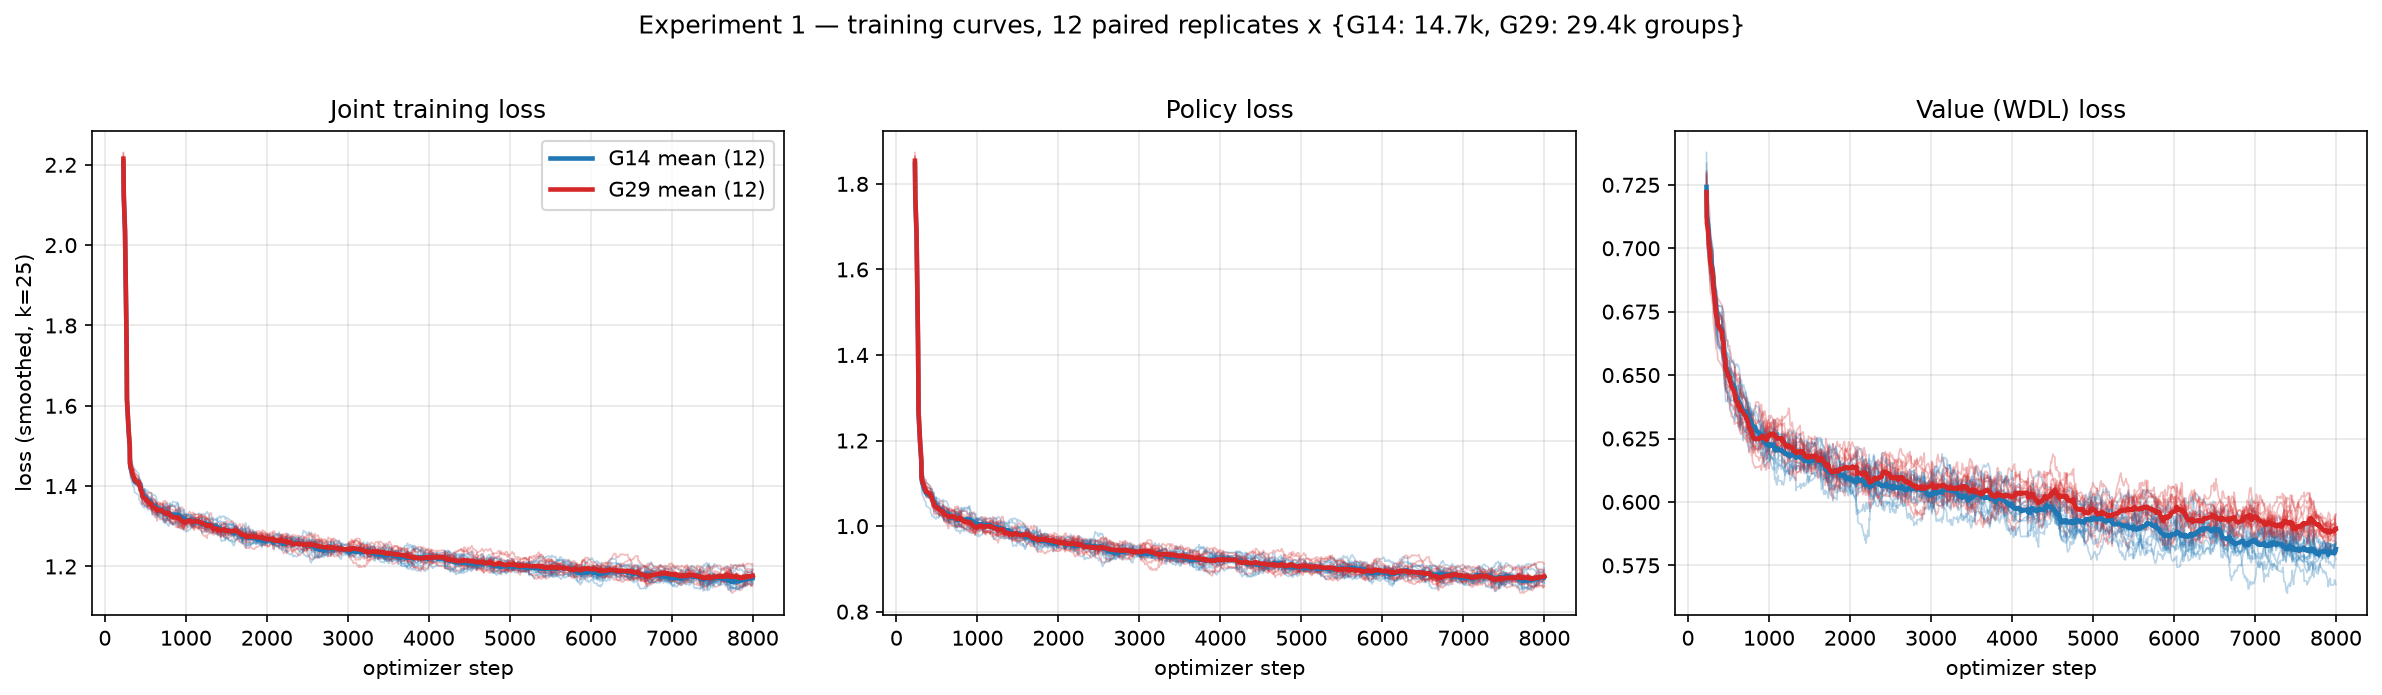
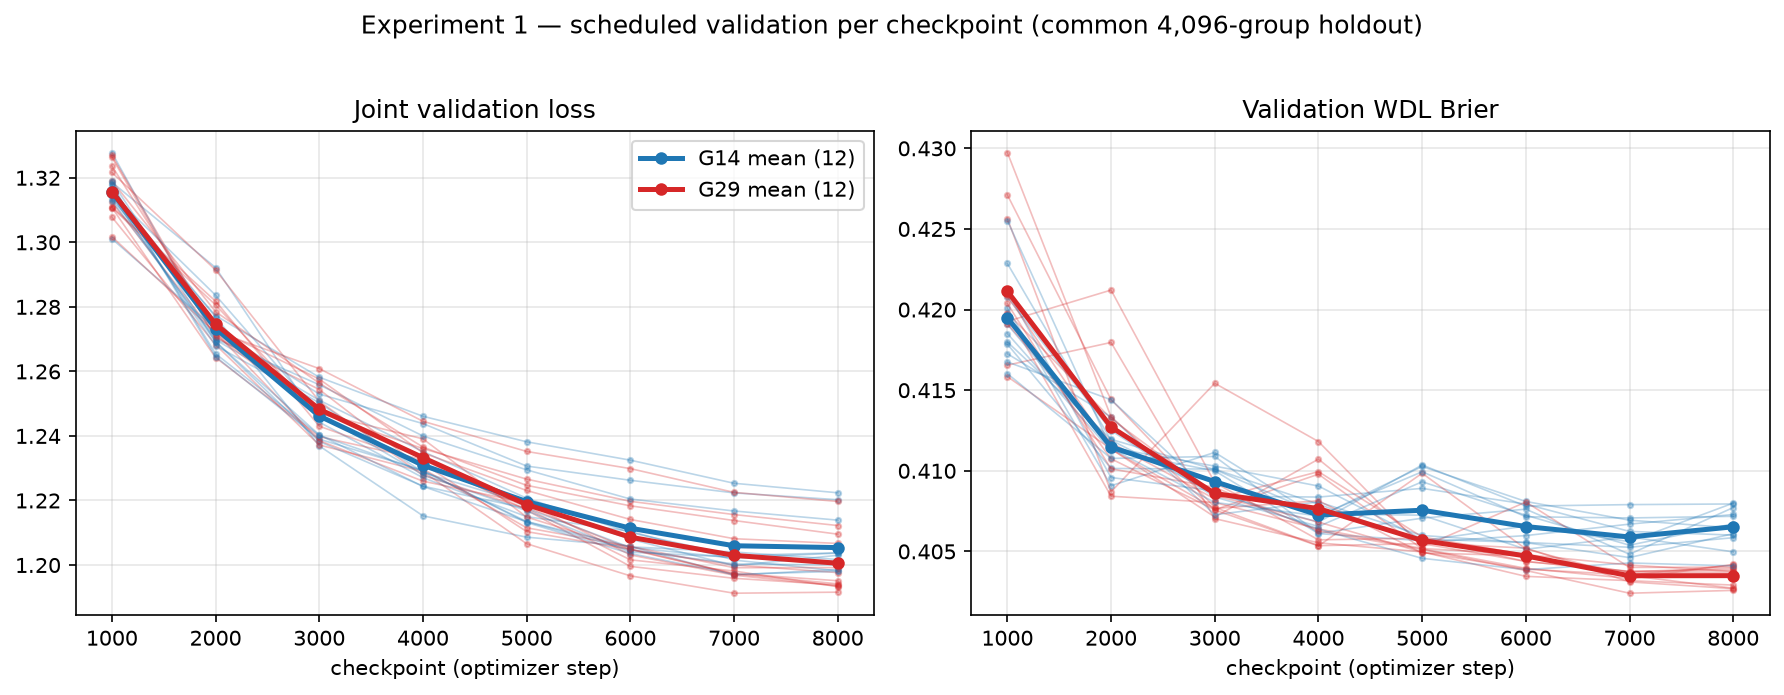
各モデルは1,000ステップごとに計8個のチェックポイントを出力し、同一の検証データセットで評価された。採用された最適チェックポイントは終盤に集中しており、G14では7,000ステップが5個、8,000ステップが7個、G29では7,000ステップが2個、8,000ステップが10個選定された。
以下の図は、チェックポイントごとの検証指標の推移を示している。選択が8,000ステップという学習予算の上限付近に集中している傾向は、より長期の学習を行った場合に結果が変化する可能性を示唆している。
さらに、実験ペアごとの検証損失の差分も確認した。同一シード条件で訓練したG14とG29の差が、モデル選定データ上でどの程度分散しているかを把握するための補助診断である。
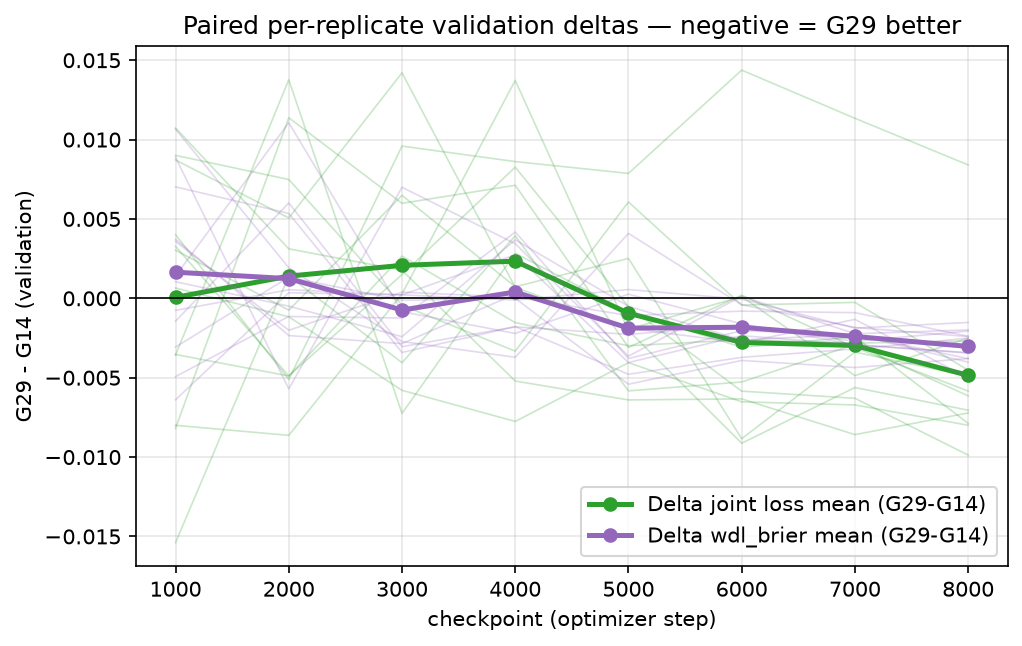
留意すべき点として、これら3つの図はいずれもモデル選定に用いた検証データに基づく途中経過に過ぎず、最終的な効果判定そのものではない。次節以降では、モデル選定後に初めて開示される独立した4,096グループのテストセットを用いて最終評価を行う。
局面評価(value)はわずかに改善
未見の4,096グループ(計8,192局)を対象に、勝敗予測精度をブライアスコア(Brier score)で評価した。
G29とG14のスコア差分は以下の通りである。
G29 − G14 = -0.0027625事前に定めていた改善閾値(-0.0027)をわずかに超え、統計的基準をクリアした。片側95%信頼区間の上限も -0.00220 とゼロを下回り、全12組の実験ペアすべてにおいてG29側が良好な予測精度を示した。
終局までの残り手数で4段階に分割した手数帯別の評価においても、すべての帯域でG29側が改善を示した。また方策(policy)の教師模倣精度についても劣化は見られず、非劣性基準を満たしていた。
オフライン指標のみを見る限り、対局数をさらに倍増させる施策は一見有効であるかのように思われた。
実対局では勝率の有意差が得られず
最終的な実力評価として、同一の32回シミュレーションPUCT探索設定のもとでG29とG14を直接対戦させた。
G29 vs G14ペアスコア(pair score) = 0.497490%信頼区間 = [0.487, 0.507]結果はほぼ完全に0.5(互角)であり、信頼区間も0.5を挟み込む形となった。
すなわち、オフラインテストにおける勝敗予測精度のわずかな改善は、実際のゲーム木探索を伴う対局性能の向上には結びつかなかった。
この結果を受け、29,400グループ(58,800局)というデータ生成設定を、現行レシピを超える改善版として採用することは見送る判断を下した。
データ追加による改善効果の逓減
前回の検証では、ゲーム数を3,675グループから14,700グループへと4倍に拡大したことで、オフライン指標だけでなく実対局の勝率にも顕著な向上が見られた。
しかし、14,700から29,400へとさらに2倍に増やした今回の試みでは、改善効果はオフライン指標の微増にとどまった。対局グループ数の対数スケールに比例して精度が伸びると仮定した線形予測と比較すると、今回得られた改善幅はその予測値の約35%にとどまる計算となる。
少なくとも現行の約42万行という学習行数の制約下においては、「対局数を増やして1局から薄く抽出する」というアプローチのレバーは飽和点(サチュレーション)に達しつつあると考えられる。
もちろん、これは対局数の拡大自体が無意味になったことを意味するわけではない。今回の実験で固定していた学習行数や更新ステップ数の上限を引き上げれば、さらなるデータ多様性の恩恵を享受できる可能性は残されている。
局面評価を重視したチェックポイント選定の試み
本実験の探索的検討として、通常の結合損失で選ぶ方式とは別に、方策損失の悪化を一定枠内に抑えつつ局面評価のブライアスコアが最良となるチェックポイントを選択するルールも検証した。
この選定ルールによるモデルを通常モデルと直接対戦させた結果、ペアスコアは 0.4972 と互角にとどまり、有意な優位性は認められなかった。また全12ペア中8ペアにおいては、両選定ルールが同一のチェックポイントを選択していた。
したがって、チェックポイント選定ルールの変更についても現状の枠組みを維持する判断とした。
まとめと今後の展望
今回の検証から得られた最大の教訓は、「教師対局数を増やせば局面評価の汎化誤差をわずかに低減できるものの、その程度の差分だけでは実対局の勝率向上には結びつかない」という事実である。
また、チェックポイントの選定が学習終盤の7,000〜8,000ステップに集中していたことから、ステップ数そのものの拡張も今後の検討課題として浮上した。ただし、現行の枠組みのまま更新ステップを増やすだけで実力が伸びる保証はない。
今後は単なる対局グループ数の拡大を追究するのではなく、局面評価の学習方法そのものを刷新する方向へ舵を切る。同一の方策学習の枠組みの中で局面評価の入力情報量を拡充するアーキテクチャの導入を、次なる最優先の実験候補として進めていく。
この記事は、実装・実験記録をもとに、本文の大部分をLLMが執筆し、筆者が内容を確認・編集しています。