U v8自己対局ループの飽和調査:第43世代でL-s0比74.9%、第47世代のリグレッションで停止
直前のincumbentであるL-s0から、PUCT-128のraw visitを学習targetにしてv8の自己対局ループを続け、どこまで伸びるかを調べた。停止規則は事前に固定し、4世代ごとに3,200対局ペアでLook判定を行った。
L-s0の時点ではまだ飽和しておらず、第43世代まで伸び続けた。第12ブロック(第47世代)でリグレッションを検出したので規則どおりループを止め、第43世代(D)を新しい正式モデルにした。
対局性能の推移
スコアは先後を入れ替えた対局ペア単位で集計し、引き分けは0.5点とした。DのスコアはL-s0相手に74.9%(1,600ペア、約+190 Elo)、F相手に77.9%(L-s0比+18.2pt)だった。相手がPUCT-512を使う条件でも71.1%で勝ち越している(L-s0比+23.0pt)。
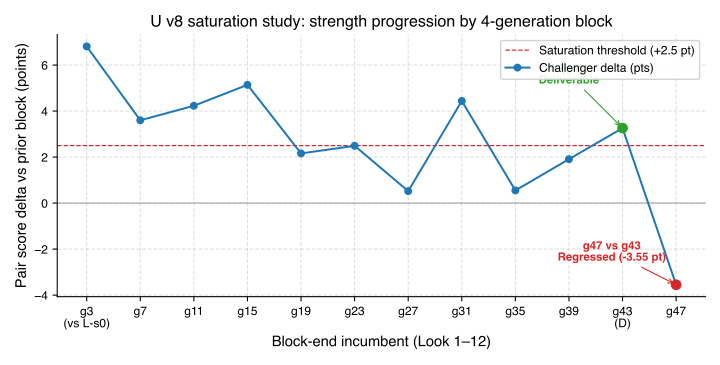
第47世代の第43世代に対するスコアは46.5%で、片側上限も48.1%と50%を下回った。共通の相手との事後対戦でも、第36世代相手で+4.7pt、L-s0相手で+2.4ptと第43世代が上回っている。特定の対戦相手との相性ではなく、全体として弱くなっていた。
過学習ではない
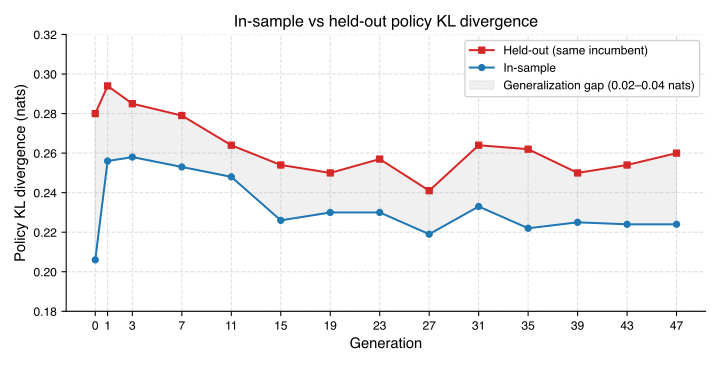
汎化ギャップは第47世代まで広がっておらず、過学習ではないと判断した。事前に決めていた「訓練への適合が進み、検証損失が悪化する」という兆候は、第7世代以降のすべての監査で出ていた。そのため、リグレッションを見分ける指標としては使えなかった。
事後分析:Value Headの偏り
性能低下の原因を事後に調べたところ、Value Headの出力バイアスが有力な候補に挙がった。
手番側の平均評価値は、第44世代で+0.034、第47世代で+0.062とプラス側に偏っていた。Value lossは評価値が全体に一様にずれてもあまり悪化しないので、通常の損失監視では気づけなかった。
第47世代のWDL出力のバイアスだけを補正し、平均評価値を0に戻して400ペアを対局させた。第43世代に対するスコアは46.25%から52.5%に戻った(+6.25pt、片側p=0.005)。このPUCT探索では、未訪問ノードの初期値に親ノードの評価値を使う(fpu_reduction = 0)。手番側の評価値が高めに出ると未訪問の手を過大評価し、探索順位が歪む可能性がある。ただし、これは事後に立てた仮説で、根拠は1回の対局テストだけだ。
まとめ
L-s0からの自己対局は第43世代(D)でL-s0比74.9%まで伸び、第47世代のリグレッションで規則どおり停止した。性能低下の原因は過学習ではない。事後分析では、Value Headの偏りがPUCT探索の手番評価を歪めたという仮説が有力になった。
この記事は、実装・実験記録をもとに、主にLLMが編集しています。