自己対局ループを6世代継続実行し、G10がG4に+6.2pt勝ち越した
第4世代(G4)の実験では、自己対局時のPUCT探索パラメータを c_puct=0.75, fpu_reduction=0.0 へ調整することで、次世代モデルの実力が向上することを確認した。今回はその学習レシピを一切変更せず、第5世代(G5)から第10世代(G10)まで6世代にわたって自己対局ループを継続実行した。
その結果、G10はG4との直接対決において+6.15ポイントの勝ち越しを記録した。ただし、後半3世代(G8〜G10)が前半3世代(G5〜G7)をさらに上回って成長し続けたかについては、統計的な確証が得られなかった。
固定強度の評価ラダー(frozen strength ladder)による追跡
3本の独立した学習系統をG4から継続させ、各世代において32,768行の新規自己対局データを抽出・蓄積しながら512ステップのオプティマイザ更新を進めた。評価フェーズでは途中で対戦条件を変更せず、clean PUCT128を用いた固定強度の評価ラダーへ各世代のモデルを対局させた。評価対局の規模は全体で144セル、計43,776局に及ぶ。
事前に定義・登録していた主要な4つの比較指標は以下の通りである。
| 評価指標 | 比較内容 | 推定差分 | 95%信頼区間 |
|---|---|---|---|
| D | G10@128 − G4@128(直接対局) | +6.15 pt | [+4.78, +7.53] |
| A | G8〜G10 − G4(ネットワーク評価対戦) | +6.45 pt | [+2.70, +10.21] |
| P | G8〜G10 − G5〜G7(後半 vs 前半ブロック) | +0.61 pt | [-1.79, +3.006] |
| H | G8〜G10 − G4(ルールベース対戦) | +1.84 pt | [+0.49, +3.20] |
指標DおよびAの結果から、G10まで学習を重ねた系統はG4よりも有意に強くなったことが確認できる。一方で指標Pの信頼区間は0をまたいでおり、後半ブロックにおける追加の成長曲線は確認できなかった。
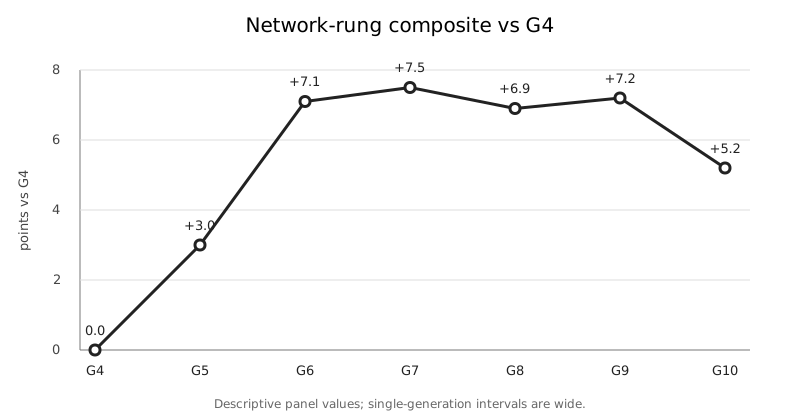
上図は各世代のネットワーク評価複合スコアを、基準となるG4との差分として示した記述統計量である。G6以降は+5〜8ポイント付近で推移しているものの、単一世代ごとの信頼区間幅は広いため、このデータのみから成長停止(プラトー)に達した時期を一意に特定することは避けている。
プラトー判定は未確定(unresolved)の結論に
事前プロトコルにおけるプラトー判定基準では、指標Pの95%信頼区間上限が+3ポイント未満であることを求めていた。実際の測定値における上限は+3.006ポイントであり、基準値をわずか約0.006ポイント上回る結果となった。そのため、事前ルールに厳格に従い、判定結果は unresolved (not a plateau)(未確定・プラトーとは認定せず)とした。
512回シミュレーション同士の記述比較においても、G7はG4に対して+7.5ポイント([+4.7, +10.4])と勝ち越した一方、G10は+2.0ポイント([-0.9, +4.9])にとどまった。G7とG10は独立した系統であるため直接の優劣比較には用いられないが、128回探索で得られた勝率改善が、より深い探索環境へ無条件に引き継がれるわけではないことを示す材料となる。
学習時のモニタリング指標も世代を経て推移していた。
| 評価メトリクス | G4 | G7 | G10 |
|---|---|---|---|
| 訪問回数ターゲットのエントロピー | 0.804 | 0.901 | 0.899 |
| 方策クロスエントロピー損失 | 1.197 | 1.414 | 1.517 |
| 局面評価クロスエントロピー損失 | 0.510 | 0.478 | 0.449 |
レシピを固定した単純な自己対局継続はG10をもって一区切りとし、今後は方策および局面評価の学習ターゲット設計、オプティマイザの更新予算、データ生成量のバランスを比較・最適化するフェーズへ移行する。6世代にわたる固定レシピの運用で得られた約6ポイントの着実な実力向上が、今後の新たなレシピ検証における確固たる比較基準となる。
この記事は、実装・実験記録をもとに、本文の大部分をLLMが執筆し、筆者が内容を確認・編集しています。